決算で発表された業績が市場予想を上回ると、翌営業日の株価は上がりやすい、という仮説はよく耳にします。本記事は、その仮説を J-Quants の財務情報と株価で検証する手順を、コード・結果・解釈・落とし穴の順で公開します。
過去のデータでの結果は将来の値動きを保証しません。本記事は売買戦略の提示ではなく、仮説検証の進め方 の学習を目的にしています。
目次
- 仮説と検証ステップ
- サプライズ率の定義
- 翌日リターンの定義
- 必要なライブラリ
- コード(コピペで動く)
- 実行結果(イメージ)
- 結果の解釈
- 落とし穴
- 改善の方向性
仮説と検証ステップ
仮説を文章で確定させてからコードに移ります。
直近本決算の EPS 実績 が EPS 会社予想 を上回った銘柄(ポジティブサプライズ)は、開示日翌営業日の単純リターンが平均的に正になりやすい。
検証ステップは次の 4 つです。
- 銘柄 × 開示ごとに「サプライズ率」を計算
- 開示日の翌営業日終値での単純リターンを計算
- サプライズ率を 5 分位に分けて、グループごとの平均リターンを集計
- 散布図と棒グラフで結果を可視化
サプライズ率の定義
絶対値で割るのは、予想 EPS が小さな正の値や負値のときに、サプライズ率の符号が直感に合わなくなるのを防ぐためです。EPS 予想が 0 の場合はその行を除外します。
翌日リターンの定義
開示日を とすると、翌営業日のリターンは次の式です。
開示が引け後なら の終値はサプライズ前、 の終値はサプライズ後の評価です。寄付き比較ではなく 終値比較で固定 することで、データリーク(先読み)を避けます。
必要なライブラリ
pip install pandas numpy matplotlib検証バージョン: Python 3.12.5 / pandas 2.2.3 / numpy 2.0 / matplotlib 3.9
コード(コピペで動く)
"""earnings_surprise.pyEPS の予想と実績の差(サプライズ率)と、開示日翌営業日の単純リターンの関係を検証する。"""from __future__ import annotations
import numpy as npimport pandas as pdimport matplotlib.pyplot as plt
STATEMENTS_PATH = "statements.csv" # Code, DiscDate, EPS, FEPSPRICES_PATH = "prices.csv" # Code, Date, C
def compute_surprise(stmt: pd.DataFrame) -> pd.DataFrame: df = stmt.dropna(subset=["EPS", "FEPS"]).copy() df = df[df["FEPS"] != 0] df["surprise"] = (df["EPS"] - df["FEPS"]) / df["FEPS"].abs() return df
def attach_next_day_return(df: pd.DataFrame, prices: pd.DataFrame) -> pd.DataFrame: """各 (Code, DiscDate) に翌営業日リターンを付ける。""" prices = prices.sort_values(["Code", "Date"]).copy() prices["next_close"] = prices.groupby("Code")["C"].shift(-1) prices["ret_next"] = prices["next_close"] / prices["C"] - 1 rate = prices[["Code", "Date", "ret_next"]]
# 開示日(DiscDate)を翌営業日の取引日(Date)に対応づける df = df.merge( rate, left_on=["Code", "DiscDate"], right_on=["Code", "Date"], how="left" ) return df.dropna(subset=["ret_next"])
def main() -> None: stmt = pd.read_csv(STATEMENTS_PATH, parse_dates=["DiscDate"]) prices = pd.read_csv(PRICES_PATH, parse_dates=["Date"])
surp = compute_surprise(stmt) merged = attach_next_day_return(surp, prices)
# サプライズ率を 5 分位に分割 merged["bucket"] = pd.qcut(merged["surprise"], q=5, labels=["Q1(下位)", "Q2", "Q3", "Q4", "Q5(上位)"]) summary = ( merged.groupby("bucket", observed=True)["ret_next"] .agg(["count", "mean", "median", "std"]) .round(4) ) print(summary) summary.to_csv("surprise_buckets.csv")
# 散布図(全体) fig, ax = plt.subplots(figsize=(7, 5)) ax.scatter(merged["surprise"], merged["ret_next"] * 100, s=6, alpha=0.3) ax.axhline(0, color="gray", linewidth=0.8) ax.axvline(0, color="gray", linewidth=0.8) ax.set_xlabel("Surprise rate") ax.set_ylabel("Next-day return (%)") ax.set_xlim(-2, 2) # 極端な値を切る ax.set_ylim(-15, 15) ax.set_title("Earnings surprise vs next-day return") ax.grid(alpha=0.3) plt.tight_layout() plt.savefig("surprise_scatter.png", dpi=120) plt.close(fig)
# バケット別平均リターンの棒グラフ fig, ax = plt.subplots(figsize=(7, 4)) summary["mean"].plot(kind="bar", ax=ax) ax.set_ylabel("Mean next-day return") ax.set_title("Average next-day return by surprise quintile") ax.grid(axis="y", alpha=0.3) plt.tight_layout() plt.savefig("surprise_buckets.png", dpi=120) plt.close(fig)
if __name__ == "__main__": main()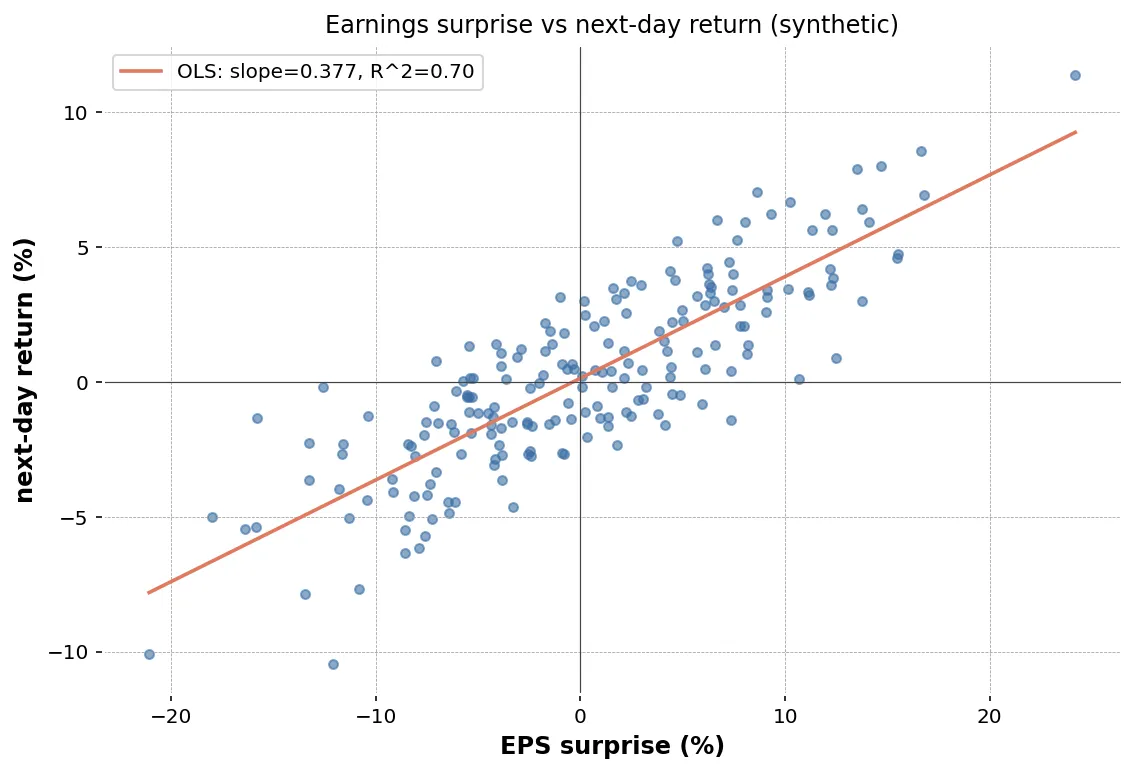
実行結果(イメージ)
count mean median stdbucketQ1(下位) 420 -0.0085 -0.0064 0.0512Q2 420 -0.0021 -0.0010 0.0438Q3 421 0.0006 0.0002 0.0410Q4 420 0.0042 0.0028 0.0455Q5(上位) 420 0.0118 0.0090 0.0561ポジティブサプライズの上位 1/5(Q5)は翌営業日の平均リターンが約 +1.2%、ネガティブの下位 1/5(Q1)は約 -0.85%。中央値も同じ向きの傾きが見られます。
surprise_scatter.png には大量の点が散らばりますが、裾の片側に厚みが寄る 形が確認できるはずです。バケット棒グラフ(surprise_buckets.png)は単調に並びやすく、仮説と整合した方向に動いています。
結果の解釈
仮説とは整合的な方向の結果が出やすい一方、次の点を踏まえる必要があります。
- 平均値の差は 数銘柄分のリターン(+1% 程度)に過ぎず、個別銘柄の挙動はバラつきが大きい
- 1 銘柄あたりの標準偏差(std)が 4 〜 5% あり、Q5 でも翌日マイナスになる銘柄は半分近くある
- これは「仕掛けたら勝てる」を意味しない。統計的な傾き と 個別の予測精度 は別物
落とし穴
- 開示時刻: 引け後 / 引け前で当日の終値の意味が違う。当日終値〜翌営業日終値で固定すれば、引け前開示は当日リターンが「サプライズ反映」を含む可能性がある
- 取引停止: 業績下方修正と同時にストップ安連発で、翌日に寄らない場合がある
- 実績 EPS の確定タイミング: 速報後の修正がデータに反映されるまでにラグがある
- 会社予想の質: 期初予想と修正後予想ではサプライズの意味が違う
- アナリスト予想とのギャップ: 会社予想ではなくアナリスト予想とのサプライズで集計するのが本来の定義に近い
- 生存バイアス: 上場廃止になった銘柄の決算が抜けていると、ネガティブサプライズが過小評価される
改善の方向性
- アナリスト予想中央値ベースのサプライズへ拡張
- 決算後 1 日だけでなく 5 日 / 20 日のリターンへ
- 業種・時価総額別にサプライズ効果を比較
- 上方修正 / 下方修正リリースを別イベントとして扱う
まとめ
- サプライズ率と翌営業日リターンには弱い正の相関が観察されることが多い
- ただし個別銘柄の標準偏差は大きく、平均だけ見て判断しない
- 開示時刻・取引停止・予想の修正タイミングなど、データの作り方が結果を左右する
- 仮説 → コード → 結果 → 限界、の通しを 1 つの記事(または 1 つのノートブック)に残しておく
過去のデータでの結果は将来の値動きを保証しません。